Datenanalyse lässt sich auf ein einfaches Ziel reduzieren: Menschen – und zunehmend auch KI-Agenten – die richtigen Informationen zur rechten Zeit am richtigen Ort zur Verfügung zu stellen.
Das ist schon alles. Es ist leicht gesagt. Aber historisch gesehen schwer zu erreichen.
Die gute Nachricht ist, dass sich das Umfeld wandelt. Mit dem Aufkommen von Data-Lakehouse-Architekturen, offenen Tabellenformaten und der wachsenden Bedeutung von Metadaten – insbesondere im Zeitalter der generativen KI – entwickelt sich der Objektspeicher zu einer Hochleistungsplattform für strukturierte Analysen.
Schauen wir uns an, wie wir hierher gelangt sind und warum dieser Wandel wichtig ist.
Von Data Warehouses über Data Lakes zu Lakehouses
Wenn man bedenkt, wie weit die Datenanalyse fortgeschritten ist, war der Prozess der Extraktion, Transformation und Speicherung von Daten in einem Data Warehouse noch vor wenigen Jahrzehnten bestenfalls zeitaufwendig. Die Geschäftsanwender gaben die Anforderungen und das Fachwissen vor, aber die Entwicklung der gesamten Lösung, einschließlich des Designs von Berichten und Dashboards, oblag der IT.
Dann kam Self-Service-BI, die es den Benutzern ermöglichte, Daten eigenständig zu erkunden – vorausgesetzt, sie waren im Warehouse verfügbar. Doch langsame Bereitstellungszyklen und starre Schemata schränkten den Zugriff oft ein.
Kombiniert mit Fortschritten bei massiv paralleler Verarbeitung und Speicherung (MapReduce, Hadoop) verlagerte sich der Schwerpunkt schließlich auf Data Lakes – skalierbare, flexible Umgebungen zum Speichern riesiger Mengen von Rohdaten. Daten waren das neue Öl geworden, und wer sie hatte, sollte einen Wettbewerbsvorteil besitzen. Doch Datenqualität und -governance blieben oft auf der Strecke.
Aber wie bei Öl, das raffiniert werden muss, wurde den Menschen klar, dass Daten transformiert, bereinigt und katalogisiert werden mussten, um einen Wert zu schaffen. Data Lakes wurden diesem Bedarf gerecht, indem sie die Flexibilität von Data Lakes mit der transaktionalen Integrität und Leistung von Data Warehouses kombinierten.
Das Leben am Data Lake war schön. Eine Zeit lang jedenfalls.
Der Einstieg von Objektspeichern
Data Lakes waren zwar hervorragend für die Speicherung strukturierter und unstrukturierter Daten geeignet, aber nicht immer ideal. Kein Wunder, dass sie oft auch als „Data Swamps“ (Datensümpfe) bezeichnet wurden, da der Fokus auf Volumen und Vielfalt lag, aber nicht immer auf der Datenqualität.
Objektspeicher vereinfachten die Datenverwaltung. Ihre Fähigkeit, unveränderliche Objekte zu speichern, machte sie ideal für strukturierte und unstrukturierte Daten. Sie waren jedoch nicht perfekt.
Zu den Herausforderungen gehörten:
- Ansammlung von ROT-Daten (redundant, obsolet, trivial).
- Dark Data – gespeichert, aber ungenutzt, beanspruchen wertvollen Speicherplatz, bieten jedoch keinen geschäftlichen Nutzen.
- Eingeschränkte Transparenz darüber, welche Daten vorhanden waren und wie sie genutzt werden konnten.
Um das volle Potenzial des Objektspeichers auszuschöpfen, benötigten wir bessere Metadaten, Governance- und Abfragefunktionen.
Und jetzt sind sie da.
Einführung der nativen S3-Tabellenunterstützung in VSP One Object
Hitachi Vantara VSP One Object bringt Objektspeicher durch die native Unterstützung von S3-Tabellen auf die nächste Stufe. Dies ist eine Branchenneuheit für On-Premises-Objektspeicher. Und die Auswirkungen sind erheblich.
Die native Unterstützung für S3-Tabellen bedeutet:
- Sie können S3-Tabellen-Buckets, Namespaces und Tabellen über vertraute S3-Tabellen-APIs erstellen und verwalten.
- SQL-basierte Analysen können direkt auf Daten in offenen Formaten ausgeführt werden – ganz ohne komplexe ETL-Prozesse oder Datenverschiebungen.
In Kombination mit integrierten Funktionen wie einem Apache Iceberg REST-Katalog, einer konfigurationsfreien SQL-Engine und einem fortschrittlichen Metadatendienst wird VSP One Object zu einer noch leistungsstärkeren Grundlage für Data-Lakehouse- und KI-Workloads.
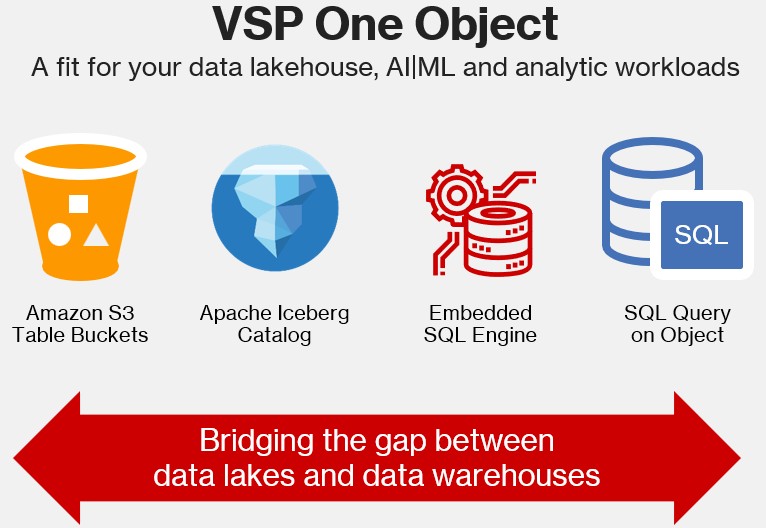
Die transformativen Funktionen der nativen Amazon S3-Tabellenunterstützung von VSP One Object ermöglichen eine vereinfachte Data-Lakehouse-Architektur, schnellere Analysen und eine nahtlose Integration mit modernen Tools wie Apache Iceberg. Sie verdeutlicht, wie Unternehmen die Lücke zwischen Data Lakes und Data Warehouses schließen können, um Erkenntnisse zu beschleunigen und KI/ML-Workloads zu unterstützen.
S3-Metadaten für intelligentere Analysen nutzbar machen
Über die Tabellenunterstützung hinaus führt VSP One Object S3-Metadaten-Logging ein. Wenn diese Funktion aktiviert ist, wird jedes Objektereignis – Erstellung, Aktualisierung, Löschung – in einem unveränderlichen Protokoll aufgezeichnet, das als S3-Tabelle gespeichert wird.
Dies bietet entscheidende Funktionen, darunter:
- Ein vollständiger, abfragbarer Verlauf der Objektaktivitäten.
- Umfangreiche Metadaten zu jedem Objekt.
- Nahtlose Integration mit Iceberg-Clients und SQL-Engines.
Jetzt können Sie sowohl Ihre Daten als auch deren Metadaten mit denselben Tools verwalten und analysieren – dies steigert Governance, Beobachtbarkeit und Leistung.
Die richtige Objektspeicherlösung zur rechten Zeit
Unternehmen stehen mehr denn je unter dem Druck, mit ihren Daten mehr zu erreichen. Und das schneller, intelligenter und in größerem Maßstab. Ob Sie KI-Modelle entwickeln, Echtzeitanalysen ermöglichen oder einfach nur versuchen, ein explosionsartiges Wachstum zu bewältigen – die Wahl der richtigen Infrastruktur ist wichtiger denn je.
VSP One Object ist genau für diesen Moment konzipiert. Es verwandelt herkömmlichen Objektspeicher in eine leistungsstarke, intelligente Plattform, die moderne Analysen und KI-Workloads mühelos unterstützt.
Es ist die richtige Lösung zur rechten Zeit und bietet:
- Native S3-Tabellenunterstützung für strukturierte Analysen.
- Integrierte Intelligenz- und Metadatendienste.
- Optimiert für KI- und Lakehouse-Workloads.
- Einfachheit, Skalierbarkeit und Geschwindigkeit.
VSP One Object ist mehr als nur Speicher. Es ist ein strategischer Enabler für Unternehmen, die das volle Potenzial ihrer Daten ausschöpfen möchten – ob strukturiert oder unstrukturiert, historisch oder in Echtzeit, von Menschen oder Maschinen generiert.
Erfahren Sie mehr darüber, warum das GigaOm Radar für High-Performance-Speicher Hitachi Vantara für Innovationen im Bereich Objektspeicher ausgezeichnet hat, oder wenden Sie sich an Ihren Ansprechpartner bei Hitachi Vantara, um Ihre Reise zur Modernisierung des Objektspeichers zu beginnen.
Weiterlesen:
 Jens Doerpmund and Mark Geel